
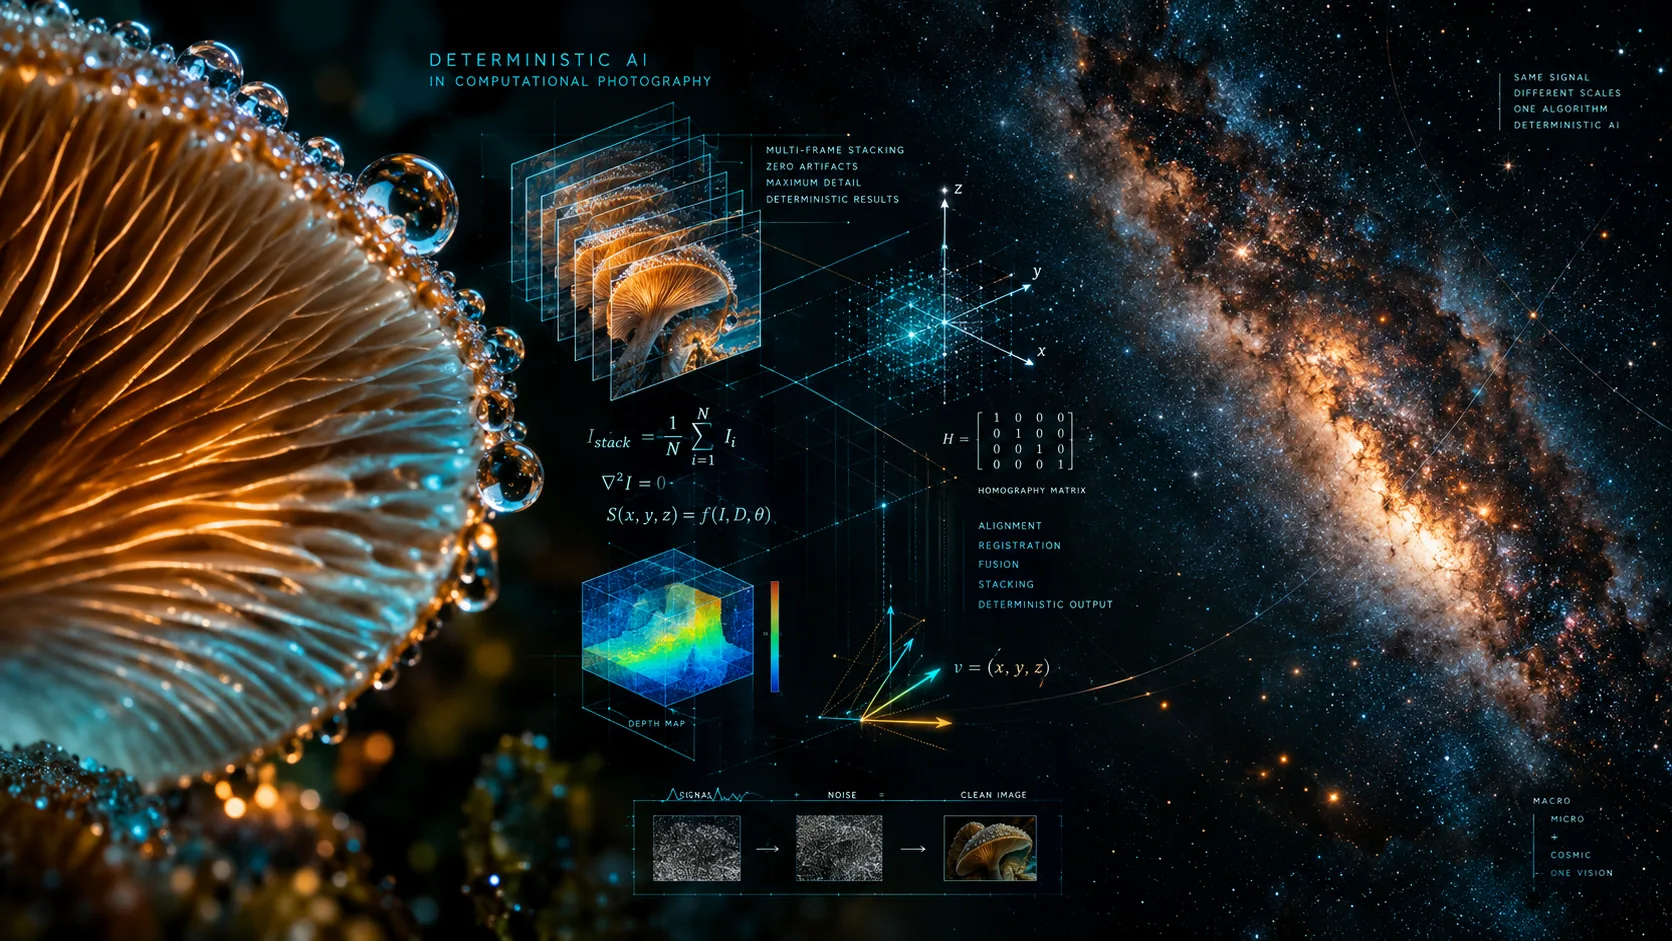
Der Ursprung von L.U.N.A.: Warum deterministische Kognition das Image-Stacking revolutioniert
1. Die Entstehungsgeschichte: Vor dem LLM-Hype war das Signal
In der aktuellen Technologielandschaft wird künstliche Intelligenz fast reflexartig mit Chatbots, Prompt-Engineering und riesigen Sprachmodellen gleichgesetzt. Kaum jemand hinterfragt, dass der eigentliche Ursprung des Projekts L.U.N.A. (Logic & Unified Neural Architecture) in einem gänzlich anderen, physikalisch harten Problemfeld lag: der hochpräzisen Signalverarbeitung und dem Multi-Modal-Stacking in der MoonEngine.
Wer sich mit anspruchsvollem Stacking beschäftigt – sei es in der Astrofotografie, beim extremen Fokus-Stacking in der Makroskopie, bei HDR-Landschaften oder hochdynamischen Sonnenfinsternis-Sequenzen –, kennt die methodischen Fallstricke: * Makro & Fokus-Reihen: Mikroskopische Fokusverschiebungen verändern den Abbildungsmaßstab (Focus Breathing), erzeugen zerrissene Kanten, Kachel-Artefakte und unschöne Beugungshalos an Übergängen. * Astro & Deep Sky: Tausende Einzelaufnahmen kämpfen gegen atmosphärische Turbulenzen (Seeing), periodische Nachführfehler und Rauschen. * Landschaft & SoFi: Statische Vordergründe müssen bitgenau gegen driftende Hintergründe maskiert werden, ohne Geistersäume zu hinterlassen. * Speicherlast: Bildstapel aus unkomprimierten 16-Bit-RAW-Dateien sprengen innerhalb von Sekunden den Arbeitsspeicher.
Der ursprüngliche Entwicklungsansatz von L.U.N.A. war daher niemals, ein weiteres Sprachmodell zu bauen. Die Vision war ein autonomer, hochpräziser Co-Prozessor, der den optischen Datenstrom versteht, verfahrenstechnische Fehler kausal erkennt und Rohsignale mit mathematischer Exaktheit zu einem perfekten Master-Bild synthetisiert.
2. Das Paradoxon generativer KI in der Bildsynthese
Viele Bildverarbeitungswerkzeuge versuchen gegenwärtig, neuronale Diffusionsmodelle oder „AI-Schärfer“ über Stacks laufen zu lassen. Für wissenschaftliche Fotografie und exakte Abbildungen ist das fatal:
- Das Halluzinations-Problem: Ein generatives Modell schätzt fehlende Pixel anhand statistischer Wahrscheinlichkeiten. In der künstlerischen Illustration mag das funktionieren; bei biologischen Makro-Strukturen, Mondkratern oder Sternfeldern erfindet die KI Details hinzu, die die Optik nie eingefangen hat. Das Ergebnis ist verfälscht und wissenschaftlich wertlos.
- Die Ressourcen-Falle: Um ein neuronales Bildmodell zu betreiben, werden 16 bis 24 GB VRAM dauerhaft gebunden. Genau dieser Grafikspeicher wird jedoch dringend für parallele Fließkomma-Berechnungen und mediane Bildfilterungen des eigentlichen Bildstapels benötigt.
L.U.N.A. geht in der MoonEngine den konsequenten Gegenweg: Deterministische Kausalität (Stufe IV).
3. Deterministisches Universal-Stacking: 5 handfeste Vorteile
Egal ob Makro-Stacking oder Milchstraße: Wenn L.U.N.A. rechnet, laufen keine stochastischen Schätzungen ab. Sie nutzt lineare Algebra, projektive Homographie, Fourier-Spektralanalysen und zweidimensionale Gradientenfelder:
[ Rohbild-Sequenz (RAW / TIFF) ]
 │
 ▼
┌──────────────────────────────────────────────┐
│ L.U.N.A. Phase 0: Lucky- & Fokus-Gate │ ◄── Misst Laplace-Varianz, SNR & Fokus-Drift
│ Kausale Selektion scharfer Bildbereiche │ Verwirft unscharfe Ausreißer deterministisch
└──────────────────────┬───────────────────────┘
 │
 ▼
┌──────────────────────────────────────────────┐
│ Phase 1: Registrierung & Alignment │ ◄── Affine / RANSAC-Transformation
│ Ausgleich von Focus Breathing & Erddrehung │ 0 MB VRAM-Verbrauch auf nativer CPU-ALU
└──────────────────────┬───────────────────────┘
 │
 ▼
┌──────────────────────────────────────────────┐
│ Phase 2: Bitgenaue Synthese │ ◄── Streifenweiser Median- / Mosaik-Stack
│ 100 % Erhaltung aller realen Sensordaten │ Volle GPU-Power für den Bildstapel
└──────────────────────┬───────────────────────┘
 │
 ▼
┌──────────────────────────────────────────────┐
│ Phase 3: Intelligent Post-Processor │ ◄── 2D-Lichtverschmutzungs-Gradientenabzug,
│ Halo-Entfernung & Kanten-Feathering │ selektive Entrauschung ohne Detailverlust
└──────────────────────────────────────────────┘
- Zero-VRAM für Kognition (Volle GPU-Power für Pixel): L.U.N.A.s Kognitionsmatrix läuft nativ auf den CPU-Rechenwerken in Mikrosekunden. Sie belegt 0 MB VRAM. Die gesamten 24 GB Videospeicher moderner GPUs bleiben zu 100 % für massive 16-Bit-Arrays und CUDA-/CuPy-beschleunigte Operationen reserviert.
- Kausale Qualitäts-Gates (Lucky-Frame & Fokus-Peaking): Frames werden anhand physikalischer Parameter bewertet: Laplace-Kantenschärfe, Entropie und Signal-Rausch-Verhältnis (SNR). Unscharfe Phasen einer Fokus-Serie oder windverzogene Astrobilder werden kausal verworfen, bevor sie das Gesamtergebnis kontaminieren.
- Universelle Artefakt-Bereinigung (Post-Processing):
- Im Makro-Bereich: Schließt Kachellücken, glättet Tiefenkarten und entfernt Unschärfe-Halos an komplexen Kanten über selektives Kanten-Feathering.
- Im Astro-Bereich: Modelliert urbane Lichtglocken analytisch über eine 2D-Flächenfunktion und zieht Streulicht bitgenau ab, ohne feine Nebelgase zu beschädigen.
- Dynamisches Hardware-Sensing: Die Kachelgrößen und Thread-Zuteilungen werden in Echtzeit berechnet: TileSize = f(AvailableRAM, ImageDimensions, BitDepth) Das verhindert Speicherüberläufe (Out-of-Memory) selbst bei Gigapixel-Panoramen oder Serien aus hunderten Fokus-Schichten absolut zuverlässig.
- 100 % Reproduzierbarkeit: Wird derselbe Bildstapel mehrfach berechnet, liefert die Pipeline auf Bitebene identische Master-Dateien. Es gibt keinen stochastischen Zufallsdrift.
4. Kann eine deterministische Architektur lernen?
Häufig wird eingewandt: „Wenn ein System rein deterministisch rechnet, ist es starr und kann nicht lernen.“ Das Gegenteil ist der Fall. L.U.N.A. lernt – aber nicht durch unkontrollierte neuronale Gewichtsverschiebungen, sondern durch empirische Falsifikation und wissenschaftliche Erkenntnis:
A. Kausales Feedback: Der Unterschied zwischen Richtig und Falsch
Im Image-Stacking ist Qualität messbar: * Erfolg: Steigt das Signal-Rausch-Verhältnis proportional zur Wurzel der Bildanzahl (√N), und nimmt die messbare Kantensteilheit zu, war die Transformation optimal. * Fehlschlag: Sinken Kontrast oder Schärfe nach der Ausrichtung, lag ein Fehler vor (z. B. fehlerhaftes Alignment durch Focus Breathing oder unzureichende Kontrollpunkte).
B. Adaptives Parameter-Tuning
L.U.N.A. vergleicht die Telemetrie vor und nach dem Prozess. Erkennt sie, dass bei einem bestimmten Objektiv Kacheln von 512 × 512 Pixeln ein präziseres Mosaik erzeugen als 1024 × 1024 Pixel, passt sie ihre interne Kognitionsmatrix deterministisch an. Der nächste Stack startet automatisch mit diesem optimierten Erfahrungswert.
C. Negative Sampling für optische Fehlervektoren (luna_wiki.db)
Wird ein Prozessschritt abgewiesen (z. B. instabiles Mosaik durch Kantenabrisse), sichert L.U.N.A. das Ereignis als Negative Sample ab. Sie speichert die genaue Ursache:
„Schwellenwert-Differenz < 1.0 bei Schärfe-Score < 4.0 führt zu Hintergrundkachelung. Schwellenwert deterministisch anheben.“
Beim nächsten Durchlauf greift dieser Schutzmechanismus bereits in Phase 0 – der Fehler wird nie wiederholt.
5. Die Dualität: L.U.N.A. Lite & der autarke Standalone-Betrieb
Ein entscheidendes Architekturziel der MoonEngine war von Beginn an die kommerzielle Standalone-Fähigkeit. Eine Software, die für jede Berechnung einen laufenden KI-Hub, Gigabytes an Server-Backends oder Cloud-APIs verlangt, ist für den praktischen Einsatz untauglich.
Deshalb wurde L.U.N.A. modular entkoppelt: * LunaLite (Headless Micro-Kern): Die MoonEngine bindet L.U.N.A.s Kognition als autarkes Modul ein. Es werden keine LLMs, keine Hintergrund-Agenten (Beaker, Simon, etc.) und keine Inferenz-Server gestartet. * Keine Ressourcen-Konkurrenz: L.U.N.A. Lite arbeitet als reiner mathematischer Filter. Selbst auf einem Laptop im Feld ohne Internetverbindung läuft die vollständige kognitive Stacking-Logik mit 0 MB VRAM-Verbrauch. * High-Compute Lock im Hub: Läuft die MoonEngine auf einer Workstation, auf der parallel der L.U.N.A. Prime Hub aktiv ist, erzwingt die Engine beim Stacking-Start einen Resource-Lock. Hintergrund-Simulationen und Modellabfragen werden pausiert, bis das Master-TIFF fertig gerendert ist.
6. Fazit
L.U.N.A. wurde nicht am Schreibtisch erfunden, um Texte zu formulieren, sondern an der harten Realität optischer Sensordaten.
Die Synthese aus der MoonEngine als universellem Stacking-Werkzeug und L.U.N.A. als deterministischer Urteilsinstanz beweist: Echte künstliche Intelligenz benötigt keine halluzinierten Pixelmuster. Sie braucht unbestechliche mathematische Kausalität, messbare Feedbackschleifen und die Fähigkeit, aus jedem physikalischen Experiment dauerhaft zu lernen.