
Neuro-symbolische Evolution: Warum lokale LLMs keine Wissensspeicher sein sollten
Wer lokale Sprachmodelle auf eigener Hardware betreibt, kennt das grundlegende Dilemma moderner KI-Pipelines: Entweder man füttert das System mit gigantischen Vektor-Datenbanken (klassisches RAG), die Bandbreite kosten und Latenzen nach oben treiben – oder man verlässt sich auf die parametrischen Gewichte des neuronalen Netzes und kämpft permanent gegen Halluzinationen, stochastisches Raten und probabilistisches Vergessen.
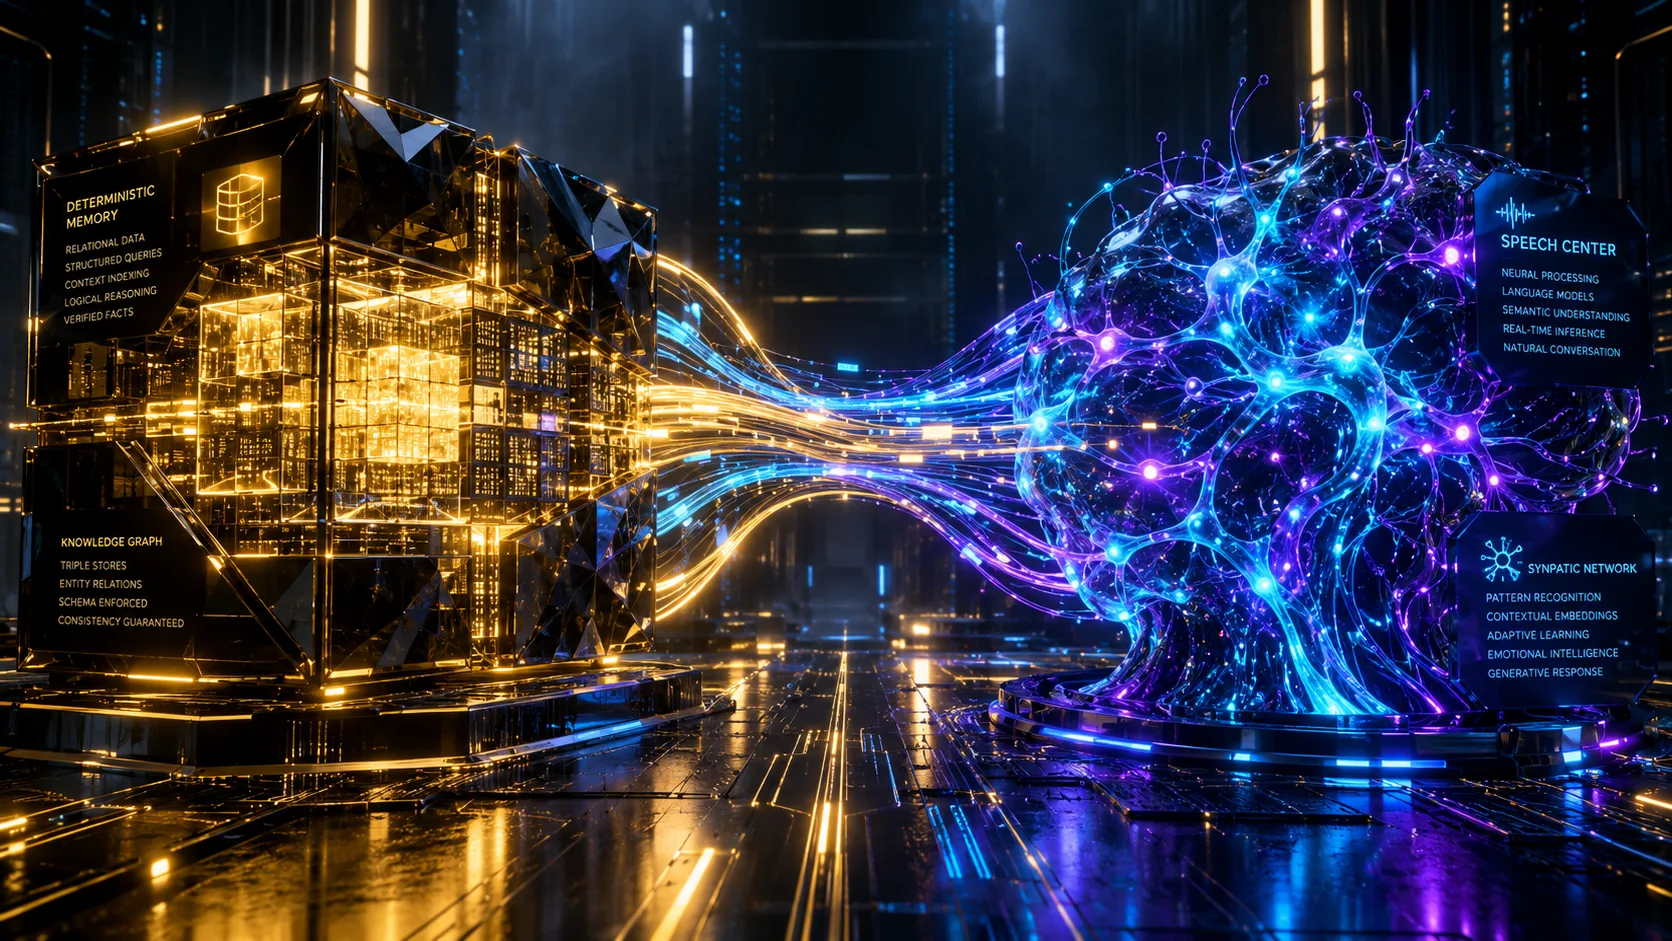
In der Systemarchitektur von L.U.N.A. Prime haben wir diesen Knoten durchbrochen. Die Lösung liegt nicht in immer größeren Parametermengen, sondern in einer strikten biologischen Funktionstrennung: Die relationale Datenbank ist das unveränderliche Langzeitgedächtnis – das lokale LLM ist das dynamische Sprachzentrum.
Das Problem: Das überlastete Sprachmodell
Klassische Chatbot- und Agenten-Pipelines bürden einem Sprachmodell drei fundamentale Aufgaben gleichzeitig auf:
- Fakten-Retrieval: Was weiß das System über Entität X? (probabilistisch aus Milliarden Gewichten gefischt).
- Logische Deduktion: In welcher ontologischen Relation steht X zu Y? (stochastisch zur Laufzeit interpoliert).
- Sprachsynthese & Formatierung: Wie wird dieses Ergebnis strukturiert, eloquent und syntaktisch fehlerfrei artikuliert?
Das Resultat auf lokaler Hardware: Hohe Inferenzzeiten von 15 bis 20 Sekunden, spürbare Latenzen und Antworten, die bei jeder Wiederholungsfrage semantisch driften oder bei Cache-Hits in unpassende Rekursionsschleifen geraten.
Der Paradigmenwechsel: Neuro-symbolische Kopplung
Unser Ansatz trennt Kognition und Speicherung deterministisch voneinander. Ein relationaler SQLite-Kernel im WAL-Modus übernimmt die Rolle des Hippocampus, während der lokale Inferenz-Dispatcher rein als Sprachrohr (Broca-Areal) agiert.
Die Kernkomponenten im Zusammenspiel
- Deterministische Ground-Truth: Fakten, Taxonomien und logische Relationen liegen symbolisch und unveränderlich in relationalen Tabellen. Sie werden deterministisch und mit Sub-Millisekunden-Latenz aus der Datenbank geholt.
- Fokussierte Sprachsynthese: Das Modell muss Fakten nicht erraten. Es erhält die verifizierte Relation direkt in den Systemkontext injiziert. Seine Rechenleistung fließt zu 100 % in das, worin Transformer herausragend sind: Kontextverständnis, Satzbau, Eloquenz und strukturierte Markdown-Ausgabe.
- Gehärteter Token-Cache: Administrative Bestätigungsfloskeln („Anweisung ausgeführt...“) werden aktiv vom Caching ausgeschlossen. Nur substanzielles Wissen passiert den semantischen Cache, wodurch Cache-Deadlocks bei semantisch invertierten Fragen ausgeschlossen sind.
Der Benchmark: Testbedingungen & Methodik
Um die Leistungsfähigkeit dieser Kopplung reproduzierbar zu messen, wurde ein dreistufiges Evaluationsverfahren für mehrdimensionale Begriffshierarchien aufgesetzt.
Testumgebung & Rahmenbedingungen
- Inferenz-Knoten: Lokales System.
- Inferenz-Engine: Lokaler vGPU-Dispatcher mit quantisierten GGUF-Modellen im VRAM.
- Gedächtnis-Backend: Relationale SQLite-Datenbanken im WAL-Modus (
user_traits&facts). - Token-Cache: 2-stufiges Caching (SHA-256 + Token-Signatur) mit striktem Ausschluss administrativer Statusfloskeln.
Das dreistufige Test-Szenario
- Stufe 1 (Freie Inferenz / Baseline): Abfrage einer mehrdimensionalen Begriffsdefinition ohne vorheriges relationales Priming. Das Modell muss Faktenfindung, logische Abgrenzung und Synthese simultan und rein probabilistisch berechnen.
- Stufe 2 (Deterministischer State-Commit): Physikalischer Schreibvorgang der validierten Relation in die relationale Struktur bei Bestätigung – ohne dass administrative Bestätigungstexte den semantischen Token-Cache korrumpieren.
- Stufe 3 (Relationale Kaskade & Invertierte Abfrage): Prüfung auf logische Konsistenz durch semantisch invertierte Prompts und Einführung tieferliegender Unterkategorien (Kaskadierung über 3 Abstraktionsebenen: Oberbegriff \longrightarrow funktionale Spezialisierung \longrightarrow strukturelle Teileinheit).
Messergebnisse & Systemverhalten
| Test-Phase | Architektur-Pfad | Latenz (Total) | GPU-Rechenlast | Semantische Drift / Halluzination |
| :--- | :--- | :---: | :---: | :---: |
| **Freie Inferenz (Baseline)** | Reines LLM (Stochastische Suche) | **17,37 s** | 100 % (Volle Pipeline) | Vorhanden (Definitionen variieren bei Umformulierungen) |
| **Geführte Synthese (Hybrid)** | SQLite Ground-Truth + LLM-Sprachsynthese | **2,63 s – 4,55 s** | Gering (Fokus rein auf Artikulation) | **0 %** (Deterministisch an Datenbank-Fakt gebunden) |
| **Gecachte Statusmeldungen** | Token-Cache Engine | **0,05 s** | 0 % GPU | Verhindert: Administrative Floskeln werden aktiv geblockt |
Was diese Ergebnisse in der Praxis bedeuten
1. Drastischer Latenzabfall (Faktor 4 bis 6 schneller)
Weil das Sprachmodell die hierarchische Einordnung nicht erst im latenten Raum deduzieren muss, entfällt der rechenintensive stochastische Suchprozess. Die Zeit bis zum ersten Token und die Gesamtdauer sinken massiv, da das Modell unmittelbar als artikulierendes Werkzeug für verifizierte Daten arbeitet.
2. Kaskadierendes Begriffswachstum
Wird eine neue Unterkategorie abgefragt, greift das System automatisch auf die bereits in der Datenbank verankerte Taxonomie zurück. Das Modell baut organisch auf dem bestehenden Begriffsbaum auf, anstatt isolierte Einzelantworten aneinanderzureihen:
Oberbegriff (Konstruktion) ──> Spezialisierung (Funktion/Zweck) ──> Teileinheit (abgeschlossener Raum)
3. Robuste Invertierungs-Stabilität
Wird die Fragestellung sprachlich umgedreht, führt dies nicht mehr zu einem fehlerhaften Cache-Treffer auf alte Quittungssätze, sondern zu einer neuen, kontextuell adaptierten Ausformulierung auf identischer Faktenbasis.
Fazit
Wirkliche Systemzuverlässigkeit entsteht nicht durch das blinde Hochskalieren von Modellparametern, sondern durch die Symbiose aus deterministischer Speicher-Architektur und neuronaler Sprachkompetenz.
L.U.N.A. Prime operiert nicht mehr rein stochastisch im luftleeren Raum: Sie greift auf ein unverrückbares relationales Wissensfundament zurück und nutzt ihr lokales Modell genau dafür, wofür Transformer geschaffen wurden – für präzise, lebendige Sprache.