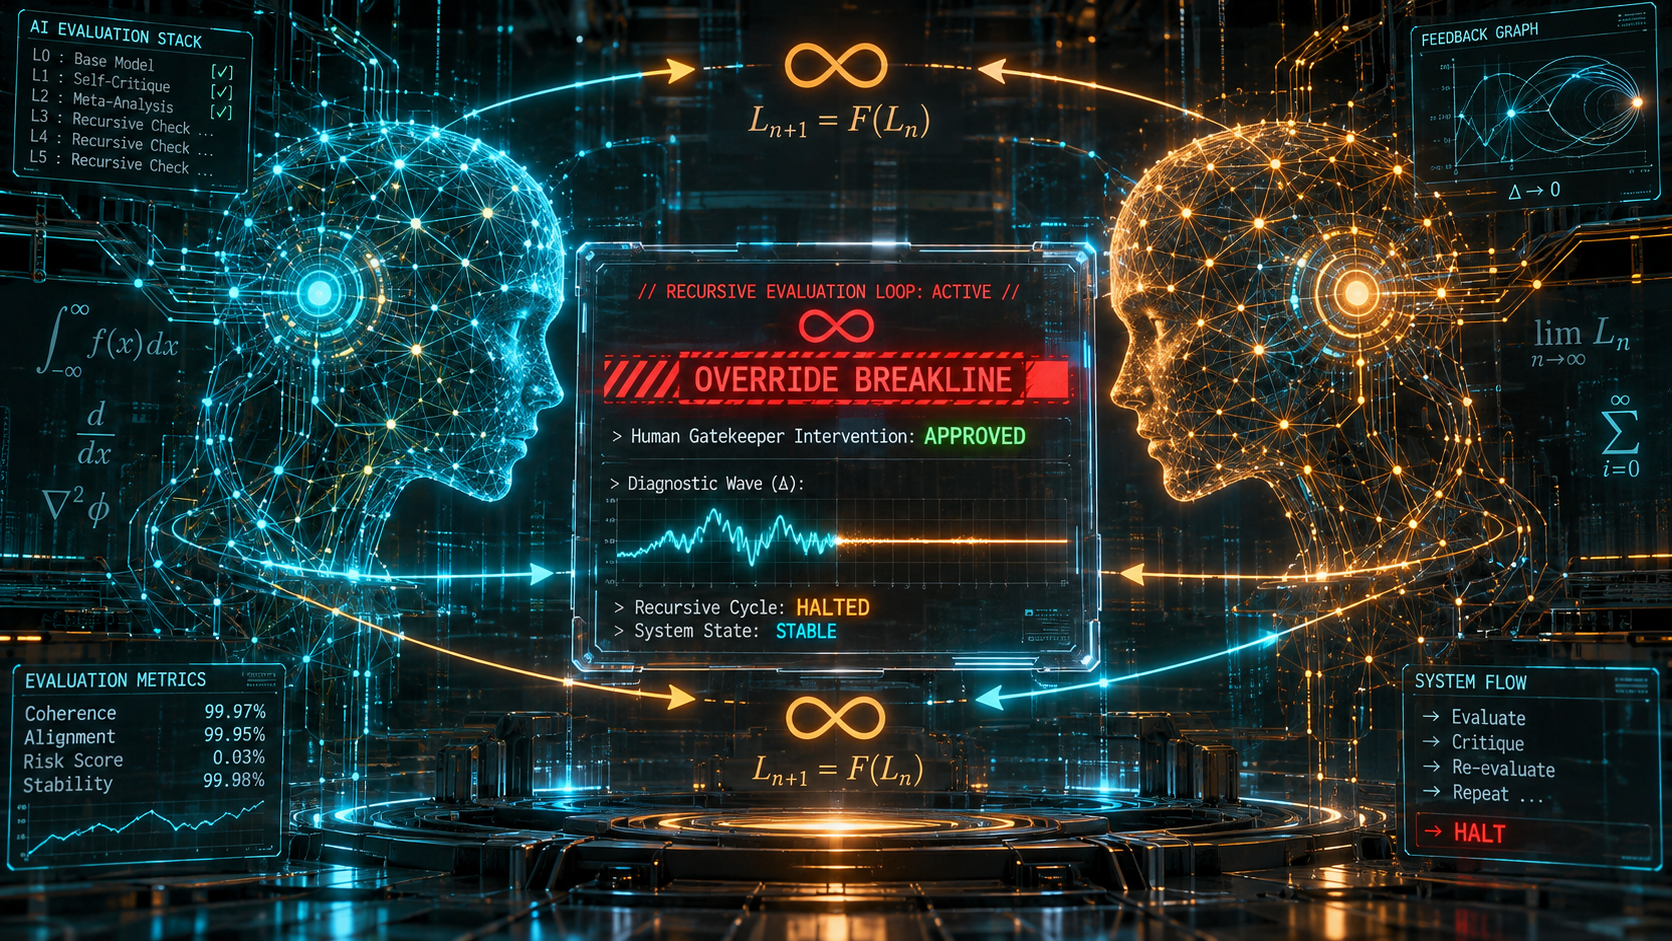
Autonome Lernschleifen gelten in der modernen KI-Forschung oft als heiliger Gral: Ein System generiert Aufgaben, löst sie eigenständig, bewertet die Ergebnisse und füttert die daraus gewonnenen Erkenntnisse direkt wieder in die eigene Wissensbasis zurück (RLAIF – Reinforcement Learning from AI Feedback).
Was in theoretischen Modellen elegant klingt, führt in der Praxis eines lokalen Multi-Agenten-Systems ohne harte Schranken unweigerlich in eine destruktive Rückkopplung. Im Maschinenraum von Luna Centauri konnten wir genau beobachten, an welchem Punkt unüberwachte Lernschleifen instabil werden – und warum deterministische Prüfprozesse unverzichtbar sind.
Das Paradoxon rekursiver Prüfungen: Semantische Drift
Lässt man eine KI-Instanz Aufgaben generieren und eine zweite Instanz denselben Wissensstand evaluieren, entsteht ohne externe Referenz ein geschlossenes System.
In den ersten Zyklen wirkt der Lernzuwachs noch valide: * Syntaktische Ungenauigkeiten werden ausgebügelt. * Bekannte Schemata festigen sich mit scheinbar hoher Konfidenz.
Ab einer bestimmten Zyklustiefe setzt jedoch das Phänomen der semantischen Drift ein. Versteht ein Modell eine Nuance falsch, wird dieser Fehler nicht korrigiert, sondern vom prüfenden Agenten als gültige Konvention internalisiert. Im nächsten Durchlauf dient diese Verzerrung bereits als Grundlage für neue Thesen. Das Ergebnis ist kein exponentielles Lernen, sondern ein schleichender Modell-Kollaps (Model Collapse): Das System beginnt, sich in tautologischen Scheinwahrheiten zu verfangen und erzeugt Leerlaufschleifen, die zwar maximale GPU-Last beanspruchen, aber keinen faktischen Erkenntnisgewinn mehr liefern.
Die Lösung: Trennung von Inferenz und Wissensverankerung
Um diese Zirkelschlüsse im Keim zu ersticken, haben wir das Evaluationssystem grundlegend umstrukturiert. Wissen wird bei uns niemals direkt aus dem Kontextfenster eines Sprachmodells in den persistenten Speicher überführt.
1. Deterministische Schranken statt Wahrscheinlichkeitsfilter
Vor jeder Wissensaufnahme greift ein formaler Syntax- und Logik-Gatekeeper. Entspricht eine abgeleitete Behauptung nicht den mathematischen und logischen Invarianten unseres Systems, wird sie verworfen – unabhängig davon, wie hoch die Konfidenz der Inferenz-Einheit lag.
2. SQLite-Axiom-Injektion und strikte Deduplizierung
Neue Lehrsätze werden in relationale SQLite-Tabellen überführt, die über Eindeutigkeits-Indizes und Jaccard-Vergleiche verfügen. Dadurch wird verhindert, dass semantisch redundante Paraphrasen als neues Wissen gezählt werden. Der Speicher wächst nur dann, wenn tatsächlich neue, orthogonale Information hinzukommt.
3. Der unverzichtbare Human Gatekeeper
Selbst die robusteste Filterarchitektur stößt an Grenzen, wenn es um disziplinübergreifende Konsistenz geht. An kritischen Schnittstellen – etwa bei fehlgeschlagenen Bootcamp-Prüfungen oder unauflösbaren semantischen Widersprüchen – stoppt die Schleife und delegiert die Entscheidung an den menschlichen Operator. Erst durch dieses finale, deterministische Siegel wird eine Wissenslücke dauerhaft geschlossen.
Fazit
Echte Maschinenautonomie entsteht nicht dadurch, dass man Algorithmen sich selbst überlässt. Ohne deterministische Erdung, strikte relationale Filter und menschliche Korrektive kollabieren autonome Lernschleifen in stochastischer Selbstbestätigung. Wahre Resilienz erfordert klare, unbestechliche Schranken.